PORTFOLIO / WORDPRESS & WOOCOMMERCE

Patryk
Szadkowski.

Od potrzeby biznesowej
do działającego rozwiązania.

Od maja 2024 roku prowadzę Chmurowo, łącząc marketing internetowy z technologią. Buduję i rozwijam strony oraz sklepy na WordPressie i WooCommerce.

Integruję formularze, systemy CRM, komunikację e-mail, rezerwacje i pomiar zdarzeń, aby wspólnie realizowały określoną potrzebę biznesową.

Zobacz moje realizacje
Patryk Szadkowski w białej koszuli na ciemnym tle
MARKETING × TECHNOLOGIACHMUROWO / OD 2024
CO MNIE NAPĘDZA

Najwięcej satysfakcji daje mi zrozumienie problemu, zaplanowanie rozwiązania i doprowadzenie go do działania. Interesuje mnie zarówno to, co użytkownik widzi na stronie, jak i przepływ danych oraz reguły ukryte za formularzem, zakupem czy zmianą statusu subskrypcji.

01 / WYBRANE REALIZACJE

Każdy projekt zaczyna się
od konkretnego problemu.

Sześć przykładów pracy z WordPressem, integracjami i danymi. Od własnej funkcjonalności po diagnozę awarii. Kolejność tematyczna, bez datowania.

  1. 01WŁASNA FUNKCJONALNOŚĆ

    Interaktywna mapa szkół jako część kursu online

    Rozproszone informacje o placówkach miały stać się czytelnym materiałem dla uczestników kursu klientki. Przygotowałem własną mapę szkół w Polsce, osadzoną w WordPressie, bez gotowej wtyczki mapowej.

    1. Dane źródłowe
    2. Normalizacja
    3. GeoJSON
    4. Mapa

    Czytaj osobne case study

    Przebieg i decyzje architektoniczne

    CASE STUDY / OD DANYCH DO INTERFEJSU

    Interaktywna mapa szkół w WordPressie

    Python · JupyterLab · pandas · GeoJSON · Leaflet · WordPress

    Droga od surowych danych pobranych z katalogu szkół do działającej warstwy danych przygotowanej pod interaktywną mapę w WordPressie. Projekt pokazuje rezultat i sposób myślenia: analizę jakości danych, diagnostykę problemów, świadomy dobór narzędzi i iteracyjne dochodzenie do rozwiązania.

    Fragmenty kodu dokumentują etapy projektu. Uwagi o dalszym rozwoju są oddzielone od opisu wykonanych prac.

    01 Cel projektu

    Celem projektu było stworzenie w WordPressie interaktywnej mapy szkół na podstawie danych pobranych z katalogu internetowego. Mapa miała umożliwiać przeglądanie placówek na terenie Polski, przybliżanie mapy, klikanie w punkty i odczytywanie informacji o szkole. Od początku projektowałem rozwiązanie tak, aby można było później dodać filtrowanie po województwie, klastry markerów, wyszukiwarkę miasta i listę placówek.

    Projekt potraktowałem jako pełny przepływ danych: źródło → analiza jakości → czyszczenie → geokodowanie → walidacja → GeoJSON → WordPress → Leaflet → interakcja użytkownika. Był to praktyczny projekt łączący data processing, web development i myślenie produktowe.

    02 Dane wejściowe i pierwsza diagnoza

    Punktem wyjścia był zbiór 146 placówek z polami: name, wojewodztwo, miasto, adres, strona, lat i lng. Pierwsza analiza wykazała, że tylko 34 rekordy miały współrzędne geograficzne, a 112 ich nie posiadało.

    Kluczowy wniosek: problemem nie była sama mapa. Bez poprawnych współrzędnych nie da się wiarygodnie narysować punktów. Najpierw należało przygotować dane. W JupyterLab sprawdziłem ich strukturę i liczbę rekordów z geolokalizacją.

    python

    df.info()
    df["lat"].notna().sum()
    Rekordów ogółem
    146
    Z lat/lng
    34
    Bez współrzędnych
    112
    03 Dlaczego automatycznie udało się zlokalizować tak mało szkół

    Niska liczba współrzędnych nie wynikała wyłącznie z ograniczeń geokodera. Głównym problemem była jakość danych pobranych ze strony źródłowej. Adresy miały różne formaty: nadmiarowe spacje, skróty „ul.”, „al.” i „pl.”, numery lokali, oznaczenia budynków, powtórzone nazwy miejscowości, literówki oraz niepełne nazwy ulic.

    Dane wejściowe

    ul. Powstańców 7A lok. U2, 05-800 Pruszków
    al. Aleja Komisji Edukacji Narodowej 95 lok. U29
    ul. Barskich 33, lok 2
    ul.Szkolna 14, 38-481 Rymanów
    ul. Szkona 4

    Takie dane są czytelne dla człowieka, ale geokoder może mieć problem z ich jednoznacznym dopasowaniem. Zamiast uznać niski wynik za ograniczenie narzędzia, przeanalizowałem wzorce w błędnych rekordach i zaprojektowałem etap normalizacji.

    04 Wybór narzędzi

    Do obróbki danych wykorzystałem Python, pandas i JupyterLab. JupyterLab pozwolił mi pracować iteracyjnie: wykonywać kolejne etapy w osobnych komórkach, sprawdzać wyniki, poprawiać dane i ponawiać tylko potrzebne fragmenty procesu.

    Do geokodowania użyłem biblioteki geopy oraz usługi Nominatim opartej o OpenStreetMap. Do wizualizacji na stronie wybrałem Leaflet i podkład OpenStreetMap. GeoJSON posłużył jako format wymiany danych pomiędzy ich przygotowaniem a frontendem WordPressa.

    Rozwiązanie miało być lekkie, łatwe do rozwijania, niezależne od płatnego kreatora map i kompatybilne z WordPressem.

    05 Czyszczenie i normalizacja adresów

    Zachowałem pełny adres do wyświetlenia użytkownikowi, a równolegle utworzyłem uproszczoną wersję przeznaczoną tylko do geokodowania.

    Przed / po

    adres: ul. Powstańców 7A lok. U2, 05-800 Pruszków
    adres_geocode: Powstańców 7A, 05-800 Pruszków

    python

    import re
    import pandas as pd
    
    def clean_for_geocode(addr):
        if pd.isna(addr):
            return ""
    
        addr = re.sub(r"lok\.?\s*[\w/-]+", "", addr, flags=re.IGNORECASE)
        addr = re.sub(r"bud\.?\s*[\w/-]+", "", addr, flags=re.IGNORECASE)
        addr = re.sub(r"\b(ul|al|pl)\.?\s*", "", addr, flags=re.IGNORECASE)
        addr = re.sub(r"\s+", " ", addr)
    
        return addr.strip(" ,")
    
    df["adres_geocode"] = df["adres"].apply(clean_for_geocode)

    To rozdzielenie było ważne: dane zoptymalizowane dla algorytmu nie muszą być identyczne z danymi prezentowanymi użytkownikowi.

    06 Geokodowanie brakujących adresów

    Dla rekordów bez lat/lng utworzyłem zapytania do geokodera na podstawie oczyszczonego adresu, miasta i kraju.

    python

    from geopy.geocoders import Nominatim
    import time
    
    geolocator = Nominatim(user_agent="szkoly_map")
    
    for i, row in df.iterrows():
        if pd.isna(row["lat"]) or pd.isna(row["lng"]):
            query = f"{row['adres_geocode']}, {row['miasto']}, Polska"
    
            try:
                location = geolocator.geocode(query)
    
                if location:
                    df.at[i, "lat"] = location.latitude
                    df.at[i, "lng"] = location.longitude
    
            except Exception:
                pass
    
            time.sleep(1)

    Opóźnienie time.sleep(1) zostało dodane celowo, aby ograniczyć częstotliwość zapytań do publicznej usługi. Po normalizacji i ponownym geokodowaniu liczba poprawnie zlokalizowanych placówek wzrosła z 34 do 124.

    Ten fragment dokumentuje przebieg projektu. W rozwijanym procesie obsługę wyjątków warto uzupełnić o zapis przyczyny błędu zamiast cichego pass; sam odstęp między zapytaniami nie potwierdza spełnienia wszystkich aktualnych warunków usługi.

    07 Ręczna obsługa wyjątków

    Po automatycznym etapie pozostały 22 rekordy bez współrzędnych. Zamiast komplikować system dla niewielkiej grupy wyjątków, wyświetliłem je osobno i zacząłem weryfikować ręcznie.

    python

    df[df["lat"].isna()][["name", "miasto", "adres"]]

    Przykładowe ręczne korekty:

    python

    df.loc[34, "adres"] = "ul. Szkolna 4"
    df.loc[25, "adres"] = "ul. Energetyków 1, Lublin"
    df.loc[9, "adres"] = "ul. Barskich 33, Wrocław"

    Automatyzuję większość procesu, ale przy nietypowych wyjątkach wybieram prostszy i bardziej wiarygodny sposób zamiast budować nadmiernie złożoną logikę.

    08 Walidacja jakości danych

    Po kolejnych etapach sprawdzałem liczbę rekordów ze współrzędnymi i analizowałem te, które nadal pozostawały bez geolokalizacji.

    python

    df[["lat", "lng"]].notna().all(axis=1).sum()
    
    df[df[["lat", "lng"]].isna().any(axis=1)][
        ["name", "miasto", "adres"]
    ]
    
    df[["lat", "lng"]].describe()

    Dodatkowo kontrolowałem, czy uzyskane współrzędne mieszczą się w realistycznym zakresie dla Polski. Sam fakt, że API zwróciło współrzędne, nie był dowodem poprawności. Wyniki wymagały weryfikacji.

    09 Pierwszy błąd GeoJSON i jego diagnoza

    Pierwszy wygenerowany GeoJSON nie ładował się w przeglądarce. W konsoli pojawił się błąd parsowania JSON. Analiza pliku wykazała wartości:

    Niepoprawny fragment JSON

    "coordinates": [
      NaN,
      NaN
    ]

    NaN jest wartością spotykaną w pandas/NumPy, ale nie jest poprawną wartością standardu JSON. Jeden taki rekord uniemożliwiał przeglądarce sparsowanie całego pliku. Rozwiązaniem było odrzucenie rekordów bez współrzędnych przed eksportem:

    python

    df_clean = df.dropna(subset=["lat", "lng"])

    Nie zmieniałem losowo kodu mapy. Najpierw odseparowałem warstwę danych od warstwy wizualizacji i znalazłem źródło problemu w niepoprawnym eksporcie.

    10 Generowanie poprawnego GeoJSON

    Po oczyszczeniu danych wygenerowałem kolekcję GeoJSON. Kolejność współrzędnych to [lng, lat], a nie [lat, lng].

    python

    import json
    
    df_clean = df.dropna(subset=["lat", "lng"])
    features = []
    
    for _, row in df_clean.iterrows():
        features.append({
            "type": "Feature",
            "geometry": {
                "type": "Point",
                "coordinates": [
                    float(row["lng"]),
                    float(row["lat"])
                ]
            },
            "properties": {
                "name": row["name"],
                "miasto": row["miasto"],
                "wojewodztwo": row["wojewodztwo"],
                "adres": row["adres"],
                "strona": row["strona"]
            }
        })
    
    geojson = {
        "type": "FeatureCollection",
        "features": features
    }
    
    with open("szkoly_map.geojson", "w", encoding="utf-8") as f:
        json.dump(geojson, f, ensure_ascii=False, indent=2)

    Jawna konwersja do float zapobiegała problemom z typami NumPy podczas serializacji. ensure_ascii=False zachowywało polskie znaki.

    Dalsze zabezpieczenie eksportu to allow_nan=False oraz kontrola wszystkich właściwości, nie tylko współrzędnych. Wówczas niedozwolona wartość zatrzyma eksport zamiast trafić do przeglądarki.

    11 Integracja z WordPressem

    Plik GeoJSON umieściłem na serwerze jako niezależną warstwę danych:

    Ścieżka danych

    /wp-content/maps/szkoly_map.geojson

    Dzięki temu można go podmieniać i w przyszłości automatycznie generować bez uzależnienia od biblioteki mediów WordPressa. Mapę zbudowałem na Leaflet.

    HTML / JavaScript

    <div id="map" style="height:600px;"></div>
    
    <link rel="stylesheet" href="https://unpkg.com/leaflet/dist/leaflet.css">
    <script src="https://unpkg.com/leaflet/dist/leaflet.js"></script>
    
    <script>
    const map = L.map("map").setView([52.1, 19.3], 6);
    
    L.tileLayer(
      "https://{s}.tile.openstreetmap.org/{z}/{x}/{y}.png",
      { attribution: "© OpenStreetMap" }
    ).addTo(map);
    </script>

    Fragment pokazuje mechanikę osadzenia. Przy utrzymaniu wdrożenia zasoby należy ładować mechanizmami enqueue WordPressa, z ustaloną wersją biblioteki. Kod w tym case study jest wyświetlany jako tekst — nie uruchamia mapy ani zewnętrznych usług na tej stronie.

    12 Dynamiczne wczytywanie danych i popupy

    GeoJSON jest ładowany dynamicznie przez fetch() i przekazywany do Leaflet. Poniższy fragment pokazuje pierwotną logikę popupu:

    JavaScript

    fetch("/wp-content/maps/szkoly_map.geojson")
        .then(response => response.json())
        .then(data => {
            L.geoJSON(data, {
                onEachFeature(feature, layer) {
                    const school = feature.properties;
    
                    layer.bindPopup(`
                        <strong>${school.name}</strong><br>
                        ${school.miasto}<br>
                        ${school.adres}<br>
                        <a href="${school.strona}" target="_blank">
                            Przejdź na stronę szkoły
                        </a>
                    `);
                }
            }).addTo(map);
        });

    W popupie zachowuję pełny adres, nawet jeśli do geokodowania używana była jego uproszczona wersja.

    Przy rozwijaniu tej implementacji dane źródłowe wymagają walidacji. Popup należy budować bez wstrzykiwania niezaufanego HTML, np. przez elementy DOM i textContent, a adres strony dopuścić tylko dla protokołów HTTP/HTTPS. Wczytywanie danych wymaga też obsługi błędnego statusu HTTP, JSON i niedostępności pliku.

    13 Projekt filtrowania po województwie

    Każdy rekord zawiera pole wojewodztwo, dlatego dane są przygotowane do filtrowania bez zmiany źródłowego zbioru. Przykładowa logika:

    JavaScript

    const filteredFeatures = schoolsData.features.filter(
        feature =>
            feature.properties.wojewodztwo === selectedRegion
    );
    
    const filteredCollection = {
        type: "FeatureCollection",
        features: filteredFeatures
    };

    To kierunek rozwoju, nie deklaracja wdrożonego filtra. Docelowo użytkownik może wybrać województwo, a mapa pokaże odpowiadające mu placówki. Rozwiązanie można rozszerzyć o liczniki szkół w regionie, klikane granice województw, klastry markerów, wyszukiwarkę miasta i synchronizowaną listę wyników.

    14 Debugging i sposób rozwiązywania problemów

    Do diagnostyki wykorzystałem konsolę przeglądarki i zakładkę Network. Sprawdzałem, czy plik GeoJSON jest pobierany, czy zwraca poprawny status HTTP oraz czy parser JSON może go odczytać.

    Do oddzielenia problemu mapy od problemu danych można użyć prostego markera testowego:

    JavaScript

    L.marker([52.2297, 21.0122]).addTo(map);

    Jeśli marker pojawia się poprawnie, podstawowa warstwa Leaflet działa. Kolejny krok to sprawdzenie danych, ich ładowania i konfiguracji warstwy GeoJSON. Takie podejście ogranicza przypadkowe zmiany i pozwala debugować system warstwa po warstwie.

    15 Rezultat
    • Analiza zbioru 146 placówek i identyfikacja 112 brakujących geolokalizacji.
    • Rozpoznanie problemu jakości i niespójności adresów.
    • Przygotowanie procesu normalizacji danych w Pythonie.
    • Zwiększenie liczby poprawnie zlokalizowanych szkół z 34 do 124.
    • Zdiagnozowanie wartości NaN blokujących parser JSON i wygenerowanie poprawnego GeoJSON.
    • Przygotowanie integracji WordPress + Leaflet + OpenStreetMap oraz popupów.
    • Zaprojektowanie filtrowania po województwie i architektury do dalszej automatyzacji.

    124 zlokalizowane placówki to wynik po normalizacji i ponownym geokodowaniu. Opis ręcznej weryfikacji pozostałych 22 rekordów nie oznacza, że wszystkie zostały ostatecznie zlokalizowane.

    16 Co ten projekt pokazuje w moim portfolio

    Potrafię przeprowadzić problem przez kolejne warstwy: od jakości danych źródłowych, przez ich przetwarzanie i walidację, po interfejs użytkownika. Wybieram narzędzia do zadania, sprawdzam hipotezy i rozdzielam problemy danych od problemów wizualizacji. Automatyzację uzupełniam ręczną weryfikacją tam, gdzie jest to prostsze i bardziej wiarygodne.

    W projekcie wykorzystałem Python, pandas, JupyterLab, geopy, Nominatim, OpenStreetMap, GeoJSON, JavaScript, Leaflet, WordPress i DevTools oraz podstawy pracy z danymi przestrzennymi przy wsparciu modeli AI.

    REZULTAT / WNIOSEK

    Jakość mapy zależała od jakości adresów. Problem widoczny w interfejsie wymagał najpierw uporządkowania danych źródłowych.

    Python / JupyterLab / pandas / GeoJSON / Leaflet / WordPress
  2. 02DIAGNOSTYKA / OPTYMALIZACJA

    Jak LiteSpeed Cache zablokował odtwarzanie filmów w kursie online

    Kursanci kupili kurs online, mieli aktywny dostęp do lekcji, ale nie mogli oglądać filmów. Filmy nie chciały się załadować.

    Przebieg diagnostyki i rozwiązanie

    Case study: WordPress, Tutor LMS, Vimeo i LiteSpeed Cache

    Kursanci kupili kurs online, mieli aktywny dostęp do lekcji, ale nie mogli oglądać filmów. Filmy nie chciały się załadować.

    Zalogowanie się do panelu jako administrator pozwalało mi odtworzyć te filmy bez żadnych problemów. Jako kursant już nie.

    Tak rozpoczęła się diagnostyka problemu, którego przyczyną okazał się konflikt między mechanizmem optymalizacji LiteSpeed Cache a odtwarzaczem wideo wykorzystywanym przez Tutor LMS.

    Rozwiązanie nie wymagało wyłączenia optymalizacji całej strony ani modyfikowania kodu platformy kursowej.

    01 / CASE STUDY

    Platforma kursowa oparta na WordPressie

    Strona klientki wykorzystywała kilka współpracujących ze sobą systemów:

    • WordPress — zarządzanie stroną internetową.
    • WooCommerce — sprzedaż kursów online.
    • Tutor LMS — zarządzanie kursami, lekcjami i dostępem uczestników.
    • Vimeo — przechowywanie i udostępnianie nagrań.
    • LiteSpeed Cache — optymalizacja szybkości ładowania strony.

    Każde z tych narzędzi odpowiadało za inny element platformy.

    Problem polegał na tym, że wszystkie mogły działać poprawnie osobno, a mimo to w określonych warunkach dochodziło do konfliktu.

    02 / CASE STUDY

    Pierwsze podejrzenie: brak uprawnień kursanta

    Naturalnym kierunkiem było sprawdzenie dostępu do kursu.

    Skoro administrator widział film, a kursant nie, można było podejrzewać problem z uprawnieniami lub integracją WooCommerce z Tutor LMS.

    Sprawdziłem więc aktywność zapisów bezpośrednio przez WP-CLI, narzędzie umożliwiające zarządzanie WordPressem z poziomu terminala.

    Wynik potwierdził, że kursanci mieli aktywny dostęp.

    Problem nie dotyczył więc dostępu do kursu. Dotyczył wyłącznie odtwarzacza wideo.

    03 / CASE STUDY

    Analiza błędów w przeglądarce

    Kolejnym etapem była analiza działania strony przy użyciu narzędzi deweloperskich przeglądarki DevTools.

    Sprawdziłem komunikaty w konsoli oraz zapytania sieciowe wysyłane podczas ładowania lekcji.

    Pojawiały się między innymi błędy związane z CookieYes, blokowaniem skryptów analitycznych i rozszerzeniami przeglądarki.

    Na pierwszy rzut oka każdy z nich mógł być potencjalną przyczyną problemu.

    04 / CASE STUDY

    Co różniło administratora od kursanta?

    Przełomem okazało się porównanie działania tej samej lekcji na dwóch kontach użytkowników.

    Wykorzystałem wtyczkę User Switching, która umożliwia przełączanie się między kontami bez konieczności wielokrotnego logowania.

    Dzięki temu mogłem sprawdzić działanie odtwarzacza w identycznych warunkach przeglądarki.

    Administrator widział film. Kursant nie.

    Zawęziłem więc analizę do mechanizmów, które mogą zachowywać się inaczej w zależności od roli użytkownika.

    Jednym z nich była optymalizacja strony.

    Wtyczki cache często inaczej obsługują administratorów i zwykłych użytkowników. Administrator może otrzymywać stronę bez części optymalizacji, podczas gdy kursant korzysta z wersji przetworzonej przez mechanizmy przyspieszające.

    05 / CASE STUDY

    Przyczyną okazał się lazy loading

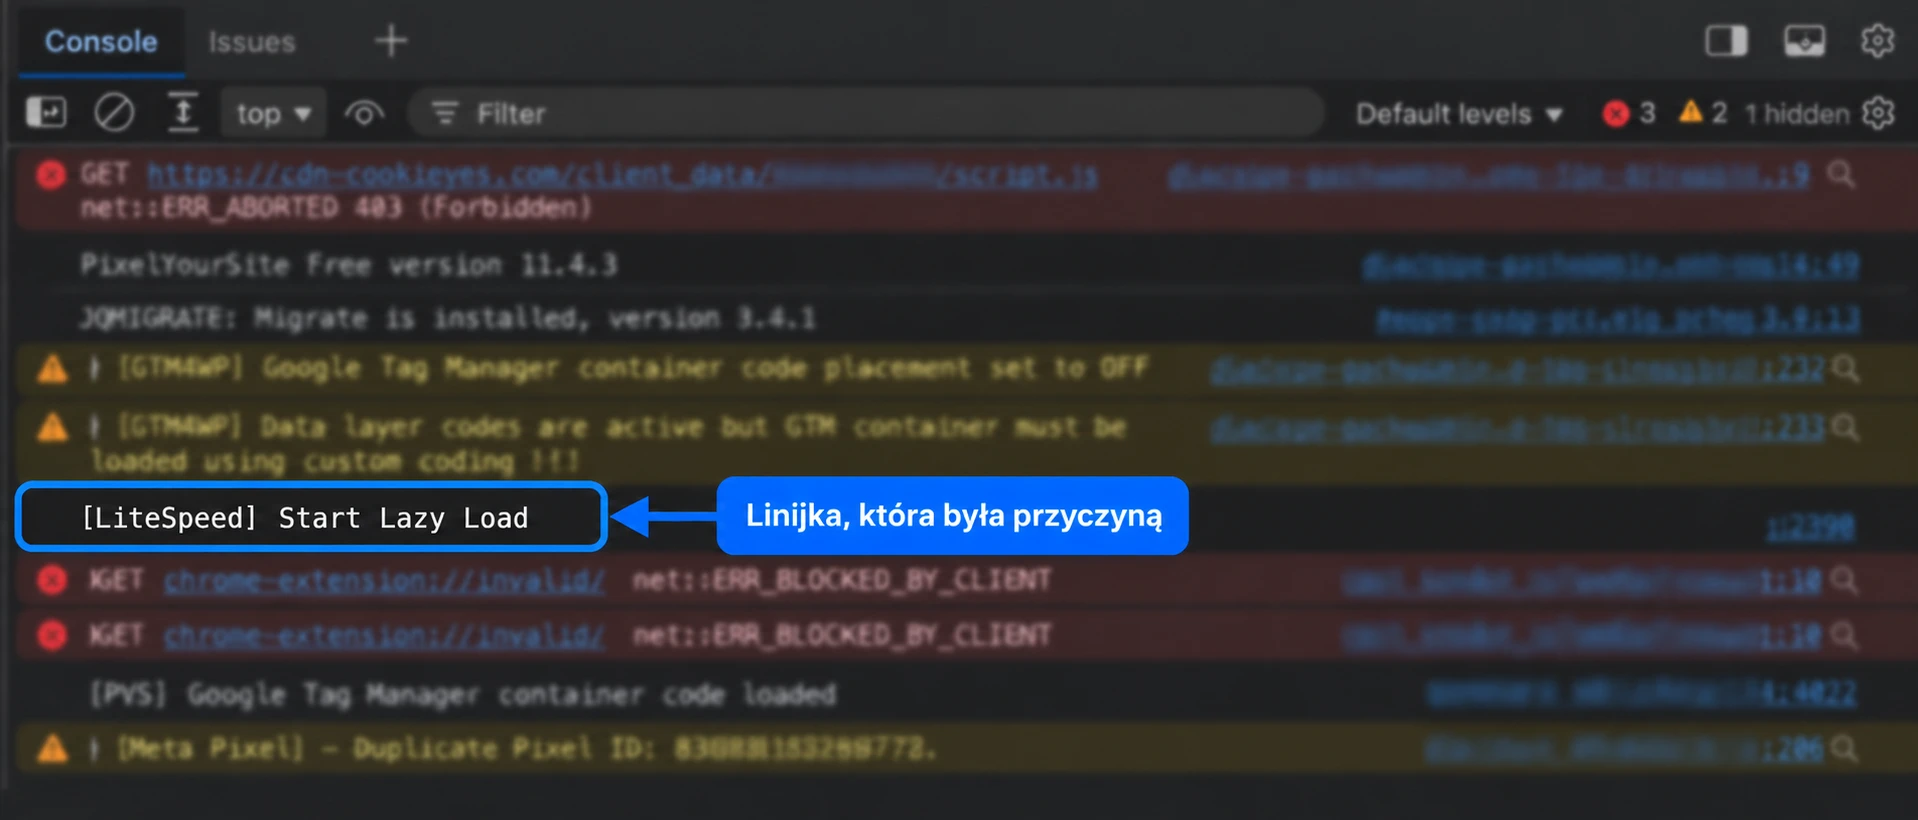
    Podczas analizy konsoli zauważyłem komunikat:

    Konsola przeglądarki z wyróżnionym komunikatem LiteSpeed: Start Lazy Load.
    [LiteSpeed] Start Lazy Load

    Lazy loading to mechanizm, który opóźnia ładowanie wybranych elementów strony, na przykład obrazów i osadzonych filmów.

    Jego zadaniem jest poprawa wydajności. Zamiast pobierać wszystkie zasoby natychmiast, przeglądarka ładuje je wtedy, gdy są potrzebne.

    Na tej stronie lazy loading był aktywny również dla iframe, czyli elementów wykorzystywanych do osadzania filmów Vimeo.

    Tutor LMS korzystał z odtwarzacza Plyr, który podczas uruchamiania potrzebował prawidłowego adresu nagrania.

    LiteSpeed Cache mógł tymczasowo zastępować ten adres, aby opóźnić pobranie filmu.

    W efekcie odtwarzacz inicjalizował się w niewłaściwym momencie.

    Zasoby Vimeo były pobierane, ale film nie pojawiał się w odtwarzaczu.

    Problem wynikał z konfliktu pomiędzy mechanizmem lazy loading a inicjalizacją odtwarzacza Tutor LMS.

    06 / CASE STUDY

    Rozwiązanie: wykluczenie tylko odtwarzacza

    Najprostszym sposobem byłoby wyłączenie lazy loading na całej stronie.

    Nie zdecydowałem się jednak na takie rozwiązanie.

    Lazy loading jest przydatnym mechanizmem optymalizacyjnym i nie było powodu, aby rezygnować z niego we wszystkich pozostałych miejscach.

    Zamiast tego skonfigurowałem LiteSpeed Cache tak, aby pomijał wyłącznie kontenery odtwarzacza Tutor LMS.

    Wykorzystałem dwie klasy CSS:

    • plyr__video-embed
    • tutor-video-player

    Zmianę wprowadziłem z poziomu serwera za pomocą WP-CLI:

    wp litespeed-option set media-iframe_lazy_parent_cls_exc $'plyr__video-embed\ntutor-video-player'
    wp litespeed-purge all

    Pierwsze polecenie dodaje wyjątek dla odtwarzacza, a drugie czyści pamięć podręczną strony.

    Dzięki temu filmy Vimeo osadzone w Tutor LMS nie podlegają mechanizmowi opóźnionego ładowania iframe.

    Jednocześnie lazy loading pozostaje aktywny dla pozostałych elementów strony, również na stronach kursów i lekcji.

    07 / CASE STUDY

    Efekt wdrożenia

    Po zmianie konfiguracji przeprowadziłem ponowny test z perspektywy kursanta.

    Film zaczął odtwarzać się prawidłowo.

    Co udało się osiągnąć?
    • Przywróciłem możliwość oglądania nagrań przez kursantów.
    • Zachowałem aktywny mechanizm lazy loading na pozostałych elementach strony.
    • Nie było potrzeby modyfikowania kodu Tutor LMS.
    • Nie wyłączałem innych funkcji optymalizacyjnych LiteSpeed Cache.
    • Ograniczyłem zmianę do elementu, który powodował konflikt.

    Rozwiązanie było niewielkie, ale wymagało wcześniejszego wykluczenia kilku innych możliwych przyczyn.

    REZULTAT / WNIOSEK

    Przywróciłem możliwość oglądania nagrań przez kursantów. Lazy loading pozostał aktywny dla pozostałych elementów strony.

    WordPress / WooCommerce / Tutor LMS / Vimeo / LiteSpeed Cache / WP-CLI

  3. 03FORMULARZE / AUTOMATYZACJA

    Zapis to jeszcze nie potwierdzenie

    Przy przenoszeniu komunikacji do FluentCRM pojawił się problem rozdzielenia statusu kontaktu od tagów uruchamiających automatyzację. Kontakt oczekujący na potwierdzenie mógł wejść do sekwencji zbyt wcześnie.

    1. Formularz
    2. Kontakt oczekujący
    3. Potwierdzenie
    4. Komunikacja
    Przebieg i decyzje techniczne

    Przygotowałem własny przepływ wykorzystujący REST API. Kontakt był zapisywany ze statusem oczekującym i odpowiednimi oznaczeniami. Uruchomienie właściwej komunikacji miało zależeć od potwierdzenia zapisu.

    Wysłany formularz potwierdza przekazanie danych. Potwierdzony zapis pozwala przejść do kolejnego etapu komunikacji. Przypisanie tagu powinno odzwierciedlać tę logikę.

    FluentCRM jest obecnie moim ulubionym systemem automatyzacji e-mail w WordPressie. Łączę jego funkcje z formularzami, segmentacją, sekwencjami i zdarzeniami zakupów lub rezerwacji. Gdy konfiguracja gotowych narzędzi nie wystarcza, przygotowuję własną integrację przy wsparciu AI.

    REZULTAT / WNIOSEK

    Rozdzieliłem zapis kontaktu od potwierdzenia, aby logika automatyzacji uwzględniała właściwy etap procesu.

    WordPress / REST API / FluentCRM / Double opt-in

  4. 04ARCHITEKTURA / OBSŁUGA KLIENTA

    WordPress jako spójny system obsługi klienta

    W projekcie dla ekspertki prowadzącej konsultacje połączyłem stronę, webinar, formularze, FluentCRM, Fluent Booking, płatności i analitykę.

    1. Zapis
    2. CRM i wiadomości
    3. Rezerwacja
    4. Pomiar
    Przebieg i decyzje techniczne

    Zaprojektowałem przepływ obejmujący zapis, double opt-in, tagowanie kontaktów, sekwencję wiadomości oraz rezerwację konsultacji.

    Warstwa pomiarowa obejmowała zdarzenia formularzy, odtwarzania materiału i kliknięć, przekazywane przez dataLayer do GTM i GA4.

    Pracowałem nad tym, aby narzędzia opisywały tę samą ścieżkę użytkownika. Dzięki temu można powiązać miejsce zapisu i źródło ruchu z dalszymi działaniami, zamiast analizować formularz, CRM i rezerwacje jako odrębne elementy.

    REZULTAT / WNIOSEK

    Rezultatem była połączona architektura obsługi i pomiaru. Jej skuteczność sprzedażowa wymaga osobnej oceny na podstawie danych z reprezentatywnego okresu.

    FluentCRM / Fluent Booking / Płatności / dataLayer / GTM / GA4

  5. 05DIAGNOSTYKA / UTRZYMANIE

    Diagnoza awarii panelu WooCommerce

    Po aktualizacji jednej z wtyczek panel administracyjny sklepu przestał działać, choć publiczna część witryny pozostawała dostępna. Trzeba było przywrócić obsługę zaplecza, ograniczając ingerencję w działający sklep.

    1. Logi
    2. Izolacja przyczyny
    3. Aktualizacja
    4. Weryfikacja
    Przebieg i decyzje techniczne

    Diagnostykę przeprowadziłem przez SSH i WP-CLI. Sprawdziłem wersje środowiska, logi PHP i historię aktualizacji. Podejrzane rozszerzenia wyłączałem pojedynczo, sprawdzając wpływ każdego z nich.

    Wyłączenie jednej z początkowo podejrzewanych wtyczek nie usunęło błędu, więc przywróciłem jej działanie. Dopiero odłączenie integracji fakturowania pozwoliło ponownie otworzyć panel.

    Po aktualizacji tego komponentu do poprawionej wersji sprawdziłem widoki administracyjne i nowe wpisy w logach.

    REZULTAT / WNIOSEK

    Dostęp do panelu został przywrócony bez cofania całej witryny i bazy danych. Najpierw izoluję przyczynę i weryfikuję hipotezy, zanim wykonam szeroką zmianę w produkcji.

    SSH / WP-CLI / Logi PHP / WooCommerce

  6. 06DANE / WIARYGODNOŚĆ ANALIZY

    Sprawdzam, co naprawdę wynika z danych sklepu

    Podczas audytu analitycznego pracowałem na 4725 zamówieniach i 16 070 pozycjach produktowych. Wykorzystałem SQL, DuckDB i Python przy wsparciu AI do uporządkowania danych zamówień, produktów i klientów.

    1. Zamówienia
    2. Kontrola jakości
    3. Ograniczenia
    4. Wnioski
    Przebieg i decyzje techniczne

    Odkryłem, że historyczna anonimizacja połączyła wiele zamówień pod jednym identyfikatorem klienta. Bez uwzględnienia tego problemu analiza mogłaby pokazać fikcyjnego klienta o wyjątkowo wysokiej wartości zakupów. Rozpoznałem też braki informacji o źródłach pozyskania.

    Rozdzieliłem dane przydatne do analizy sprzedaży od tych, które wymagały ostrożności przy ocenie powracających klientów i CLV.

    Znajomość marketingu pomaga mi patrzeć na sklep również od tej strony: sposób zapisu i przekazywania danych wpływa na późniejsze decyzje. Nawet poprawnie działający interfejs może dostarczać informacje prowadzące do błędnych wniosków.

    REZULTAT / WNIOSEK

    Określiłem, które wnioski mają oparcie w danych, a gdzie anonimizacja i braki informacji ograniczają analizę.

    WooCommerce / SQL / DuckDB / Python / Jakość danych

02 / WARSZTAT

Jak pracuję
z kodem i AI.

Nie jestem programistą w tradycyjnym rozumieniu tej roli. Do tworzenia kodu wykorzystuję modele AI. Moją pracą jest zrozumienie potrzeby, określenie zasad działania, pokierowanie implementacją oraz sprawdzenie jej w kontekście całego projektu.

AI rozszerza moje możliwości, ale wygenerowany kod traktuję jako rozwiązanie wymagające weryfikacji.

  1. 01 / WYMAGANIA

    Najpierw zasady działania.

    Zanim powstanie kod, ustalam, co rozwiązanie ma robić, jakie dane otrzyma i jakie sytuacje musi obsłużyć. Przy subskrypcjach rozróżniam anulowanie przyszłego odnowienia od utraty opłaconego dostępu. Przy formularzu rozdzielam wysłanie danych, zapis kontaktu i potwierdzenie zgody.

  2. 02 / KONTEKST

    Instrukcje zamiast domysłów.

    AI potrafi pominąć obsługę błędu, zastosować nieaktualny interfejs albo zmienić fragment rozwiązania bez zrozumienia jego roli. Przygotowuję standardy dopasowane do projektu, ograniczam zakres zmian i sprawdzam propozycje względem dokumentacji.

  3. 03 / PRZEGLĄD

    Druga perspektywa na kod.

    Zazwyczaj przekazuję kod do przeglądu innemu agentowi niż ten, który przygotował implementację. Proszę o szukanie błędów w logice, brakującej walidacji i przypadków brzegowych. To dodatkowa warstwa kontroli. Potwierdzeniem działania pozostają testy i obserwacja rzeczywistego zachowania rozwiązania.

  4. 04 / BEZPIECZEŃSTWO

    Interfejs to dopiero początek.

    Dobieram REST API, hooki i interfejsy ekosystemu WordPress do zadania. Dbam o walidację i oczyszczanie danych wejściowych, właściwe uprawnienia, bezpieczne wyświetlanie danych i obsługę błędów komunikacji. Samo REST API nie przesądza o bezpieczeństwie — znaczenie mają reguły dostępu i możliwości endpointu.

  5. 05 / WERYFIKACJA

    Sprawdzam zmianę w całym systemie.

    Tworzę testy adekwatne do ryzyka: sprawdzam prawidłowy przebieg, sytuacje błędne i wpływ na istniejące funkcje. W sklepie nowa integracja musi współistnieć z działającymi płatnościami, panelem administracyjnym i obsługą subskrypcji.

03 / WSPÓŁPRACA

Porozmawiajmy
o kolejnym projekcie.

Najbardziej interesują mnie projekty WordPress i WooCommerce wymagające własnych funkcjonalności, integracji i automatyzacji. Lubię rozumieć reguły biznesowe, porządkować przepływ danych i sprawdzać rozwiązania w praktyce.

Wnoszę doświadczenie z komercyjnych wdrożeń, znajomość otoczenia marketingowego i nawyk szukania przyczyny problemu przed wyborem rozwiązania. Rozwijam warsztat techniczny i świadomą pracę z AI.

Współpraca B2B · Elastyczny czas pracy

patryk.szadkowski@gmail.com

Patryk Szadkowski